ACT:原文阅读
今天大概花了两个半小时,看了一下 ACT 的原文。
感觉整篇文章比较突出的贡献,是把心理学上类似 Action chunking、Action chunk 的概念应用到了具身智能领域,主要解决了克隆学习 BC 上类似误差累积的问题。
我认为比较突出的算法贡献,其实是 Action chunk 的应用,以及它提出了一套比较低成本的设备。
整体上感觉还有一点,就是原先复现没有观察到的细节。它的数据好像都是在 Leader 臂 上取的,可能涉及低级的 PID controller 问题,需要让 lower 臂能跟上。这个设计的就和舵机有点关系了。以及补充的z向量和cls向量的详细运算,可能自注意力的编码器我还没具体处理过。通过CVAE来解决了示教数据多样的问题。 以及Temporal Ensembling来解决推理过程的动作衔接问题。
当前疑问: 整体感觉可能只是 Action chunk 跟 Transformer 简单结合了一下。但我现在比较核心的疑问是,它是不是利用 Transformer 直接类似地输出最后的关节空间。怎么说呢,还是有点类似黑盒的感觉,可能后续的文章还要再多读一点。
ACT 改了什么
论文的题目是 Learning Fine-Grained Bimanual Manipulation with Low-Cost Hardware,作者来自 Stanford、UC Berkeley 和 Meta。文章写的是一整套系统,硬件和算法各占一半:前面用相对便宜的 ALOHA 做双臂遥操作和示教采集,后面用 ACT 学习精细的双臂操作。
论文摘要报告了 6 个真实世界任务上的约 80%–90% 成功率,示教量大约是 10 分钟,或者每个任务 50 条轨迹。这个结果当然很有吸引力,但它属于论文里的 ALOHA、任务设置、相机和评测协议,不能直接搬到 SO-101 上当成保证。
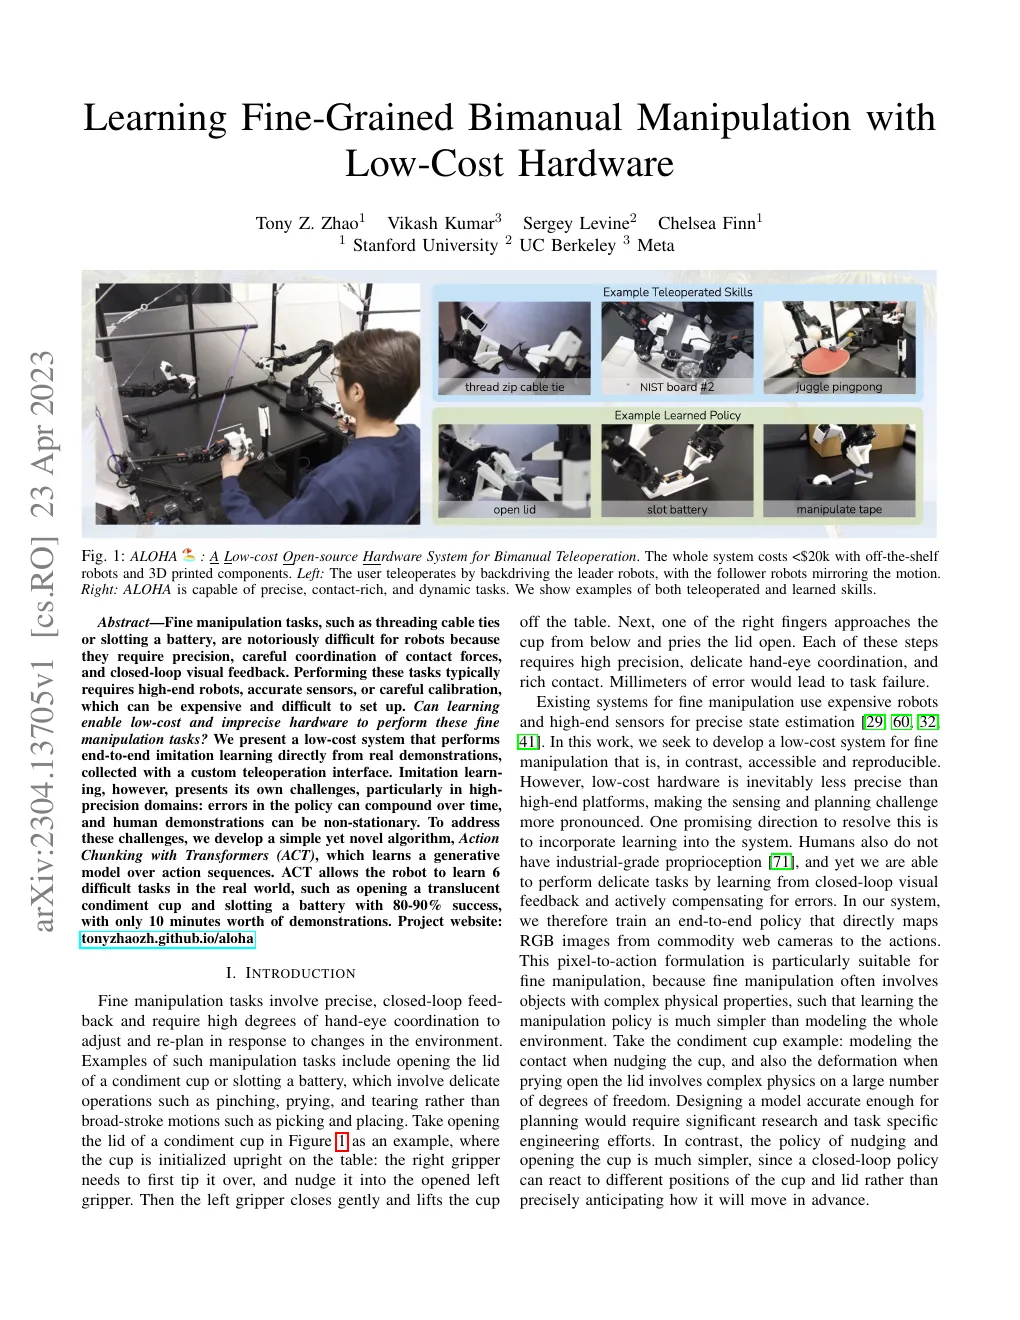
图 1:论文首页。左边是低成本双臂遥操作系统,右边是遥操作技能和学习策略的示例。
动作块
单步行为克隆的直觉很简单:给模型当前画面和当前状态,让它猜下一步动作。
当前画面 + 当前机器人状态 → 下一步动作麻烦也从这里开始。机器人只要有一次小偏差,下一时刻看到的状态就可能已经不在示教数据分布里。模型面对这个陌生状态再错一点,偏差会继续往下传。夹爪偏几毫米,可能就从抓住物体变成碰到物体,后面的动作很难再补回来。
ACT 把监督目标换成了未来一段动作:
当前画面 + 当前机器人状态 → 未来 k 步动作这让模型有机会学到一小段完整过程,比如靠近、下降、闭合、抬起,而不是把每个动作都当成孤立的一步。部署时,连续的动作块也比一连串互不相干的单步预测更容易保持节奏。
Action Chunking 减少了模型频繁做短视决定的次数,也减轻了误差累积,但它没有消除误差累积。动作块多长、每次实际执行几步、多久重新读一次相机,都会改变最后的真机表现。
架构图
Fig. 11 把 Training 和 Testing 画在了一起,看上去像有两套模型。其实它主要在回答两个问题:训练时,模型怎样从示教动作里得到 z;执行时,模型怎样只靠当前观察输出一段动作。
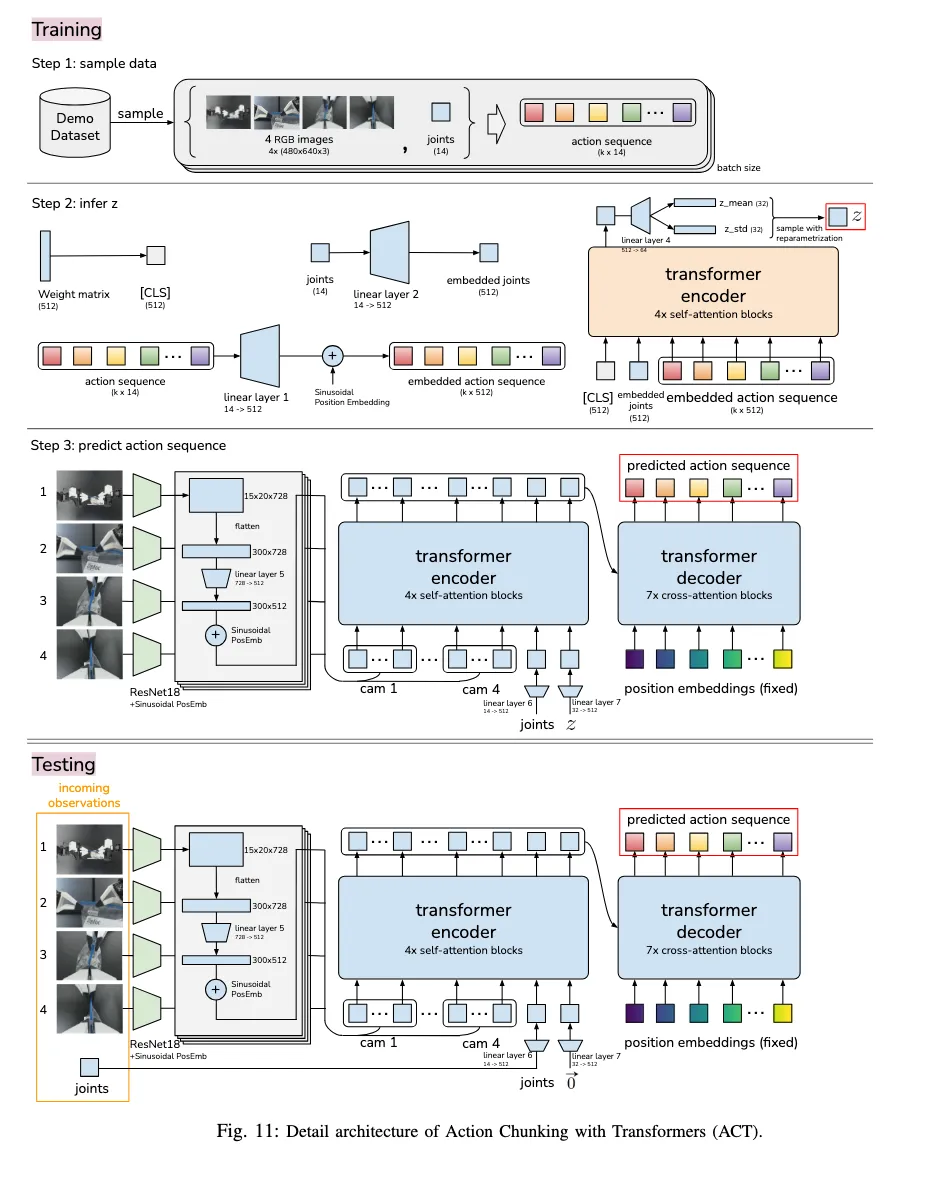
图 2:会话中你贴的论文网络图。训练时会额外使用未来示教动作提取 z,测试时这条分支被拿掉。
一份样本
假设人通过遥操作完成了一次拿杯子任务。训练时从这条轨迹的时刻 t 取出一份样本,大致包含下面这些东西:
| 图里的东西 | 人话解释 |
|---|---|
| 4 RGB images | 同一时刻的 4 个相机视角,不是连续 4 帧 |
| joints | 这一刻机器人各个关节的实际状态 |
| action sequence | 从 t 开始,示教者接下来发出的 k 步动作 |
| batch | 一次拿多份这样的样本一起训练 |
这里最容易看错的是四张图。它们是同一时刻的不同视角,不是时间上连续的四帧。可以把输入理解为一个观察锚点:一帧画面,加上这一刻的机器人状态;监督信号则来自同一条 Episode 的未来动作。
joints 和 action 也不是同一个东西。前者描述机器人现在在哪里,后者描述示教者希望它接下来怎么走。论文里的双臂动作有 14 个数,两只机械臂各 6 个关节,再加上两个夹爪,所以动作段可以写成 k × 14。
你之前提到能不能让每一个 step 对应一次图片生成。这个办法很适合做教学动画,但它不是 ACT 的真实计算过程。ACT 每一步读取的是相机图像和关节状态,网络最后输出的是数字动作。如果我们把每个 step 画成一张图,图片生成器只是把状态变化渲染出来,帮助人看懂数据流,不能替代真实的视频输入。
z 从哪里来
这部分看起来有点像先偷看答案。当前画面相似时,人并不一定每次都用完全相同的路线拿东西:有人会直着靠近,有人会绕一点;有人动作快,有人中间会停一下。只给模型当前画面,未来动作并不总是只有一个合理答案。
ACT 用一个条件 VAE,也就是 CVAE,把这段示教动作里的差异压缩成一个低维变量 z。z 不是人手写的标签,不代表某一个固定的方向或速度。它更像是这次示教的动作方式留下的一份压缩信息。
这条训练辅助分支可以先这样看:
当前 joints + 未来示教动作
              ↓
      Transformer encoder
              ↓
       z 的均值和标准差
              ↓
        采样一个 32 维 z
图里的模块不用一开始就全背下来。
Linear layer把 14 维的关节或动作投影到 512 维内部表示。512 是网络的表示宽度,不是机器人突然多了 512 个关节。Position embedding给动作序列保留顺序,让模型知道第 1 步和第 20 步不是同一个位置。[CLS]像一个汇总栏,把整段输入的信息收拢起来。mean / std让网络输出一个分布,而不是一个写死的 z。Reparameterization可以先记成z = μ + σ × ε,也就是中心值加上随机扰动。这样采样之后,训练误差仍然能传回前面的网络。
这算不算作弊?不算。未来示教动作只在训练时用于这条辅助分支,机器人执行时没有这份答案可以看。KL 约束也会限制 z,不让它把整段动作原封不动地藏进去。
策略网络
训练辅助分支得到 z 之后,真正的策略网络要做的事情可以写成:
当前图像 + 当前 joints + z → 未来 k 步动作ResNet-18 先处理相机画面。原始图片只是像素,网络要从里面找出和动作有关的东西,比如物体在哪里、夹爪边缘在哪里、是不是已经接触到物体。ResNet 输出视觉特征图,flatten 把画面上的网格排成一列,位置编码则保留每个特征原来位于画面哪个区域。
接着,另一个 Transformer encoder 把视觉特征、当前关节状态和 z 放到一起处理。这里的 z 不是相机看到的内容,它提供的是示教动作的变化信息。模型需要同时知道物体的位置、当前姿态和这次动作可能采用的方式,才有机会预测出合适的动作。
decoder 底下那排固定位置向量,可以想成 k 个已经编号的空位:第一个空位对应未来第 1 步,第二个空位对应未来第 2 步,以此类推。它们通过 cross-attention 读取前面编码好的观察信息,最后每个位置输出一个动作向量,合起来就是 k × 14。
ACT 的一次前向计算可以直接给出整段动作,不需要像自回归语言模型那样,先生成第一个动作,再把它喂回去生成第二个动作。这个区别正是 Action Chunking 的实现基础。
你贴的图里还有一个小问题:视觉特征的一处标注是 728 维,但正文写的是 512 维。这里更像是图和正文之间的表示细节没有完全对齐,不值得拿 728 去反推整套网络。
损失
模型输出动作之后,会把预测序列和示教序列按时间位置对齐:预测第 0 步对示教第 0 步,预测第 1 步对示教第 1 步,依次比较。
总损失 = 动作重建误差 + β × KL 约束动作重建误差负责让策略学会怎么移动。KL 约束负责把 z 控制在一个比较规整的分布里,也让测试时用先验中心 z = 0 这件事变得有意义。
推理时
机器人真正执行时,当然拿不到示教者接下来要做什么。所以 Training Step 2 那条读取未来动作的分支会被拿掉,剩下的是视觉编码、关节状态、Transformer 和 decoder。
当前相机画面 + 当前 joints + z=0
                    ↓
              已训练好的策略
                    ↓
              未来 k 步动作
这里的 z=0 容易被误解。它不是让机器人执行零动作,也不是把图片清零,而是在没有未来示教动作可看的时候,使用先验分布的中心位置来运行策略。
Temporal Ensembling
动作块让每次预测变长了,新的问题也随之出现:不同时间发起的预测会重叠。
假设每次预测 4 步。到了执行时刻 t+2,模型手里可能同时有三份针对这个时刻的建议:最早那次预测里的 A₂,下一次预测里的 B₁,以及刚刚预测出的 C₀。
| 预测发生的时刻 | 针对 t | 针对 t+1 | 针对 t+2 | 针对 t+3 |
|---|---|---|---|---|
| t | A₀ | A₁ | A₂ | A₃ |
| t+1 | — | B₀ | B₁ | B₂ |
| t+2 | — | — | C₀ | C₁ |
Temporal Ensembling 做的是把 A₂、B₁、C₀ 这几份针对同一个执行时刻的动作加权融合。它不是把相邻时刻的动作直接平均。这样,机器人每次还能用到新的视觉观察,动作也不至于因为换了一次预测就突然跳一下。
预测了 k 步,也不代表机器人必须闭着眼执行完 k 步。具体执行多少步、多久重新查询一次策略、如何处理重叠动作,都是部署配置。这个配置如果和模型训练时的动作块假设对不上,真机上很容易出现看起来像模型坏了的问题。
为什么值得读
论文有意思的地方,不只是最后报出了一个成功率。它把低成本硬件、示教采集、动作表示、网络结构和真实机器人限制放在了一条链上。硬件没做好,数据就不稳;数据不稳,后面的模型会把问题一起学进去。
Action Chunking 也确实抓住了行为克隆的一个痛点。它没有先把问题包装成一个必须精确模拟全部接触物理的庞大系统,而是先改了策略学习和执行的基本单位。对拿取、插入、折叠这类需要连续接触的任务,这个切入点很直接。
CVAE 则承认了一件常被忽略的事:同一个画面,未来并不一定只有一条正确路线。Temporal Ensembling 又把动作连续性和反馈放在了一起。模型预测一段,但每次仍然可以结合新的观察修正后面的动作。
当然,论文的限制也应该一起读。ALOHA 的硬件能力、相机布置、示教方式和任务难度都很具体,论文里的 80%–90% 成功率不能脱离这些条件单独解释。遇到需要更大力量、更复杂感知或多阶段接触的任务,ACT 也不会因为用了 Transformer 就自动变容易。
回到 50 条示教
论文讲的是 ALOHA 双臂系统,我们最后一次训练是在 SO-101 上做的单臂适配,输入是一台腕部相机,任务是抓起蓝色胶带卷,再把它放进白色托盘。
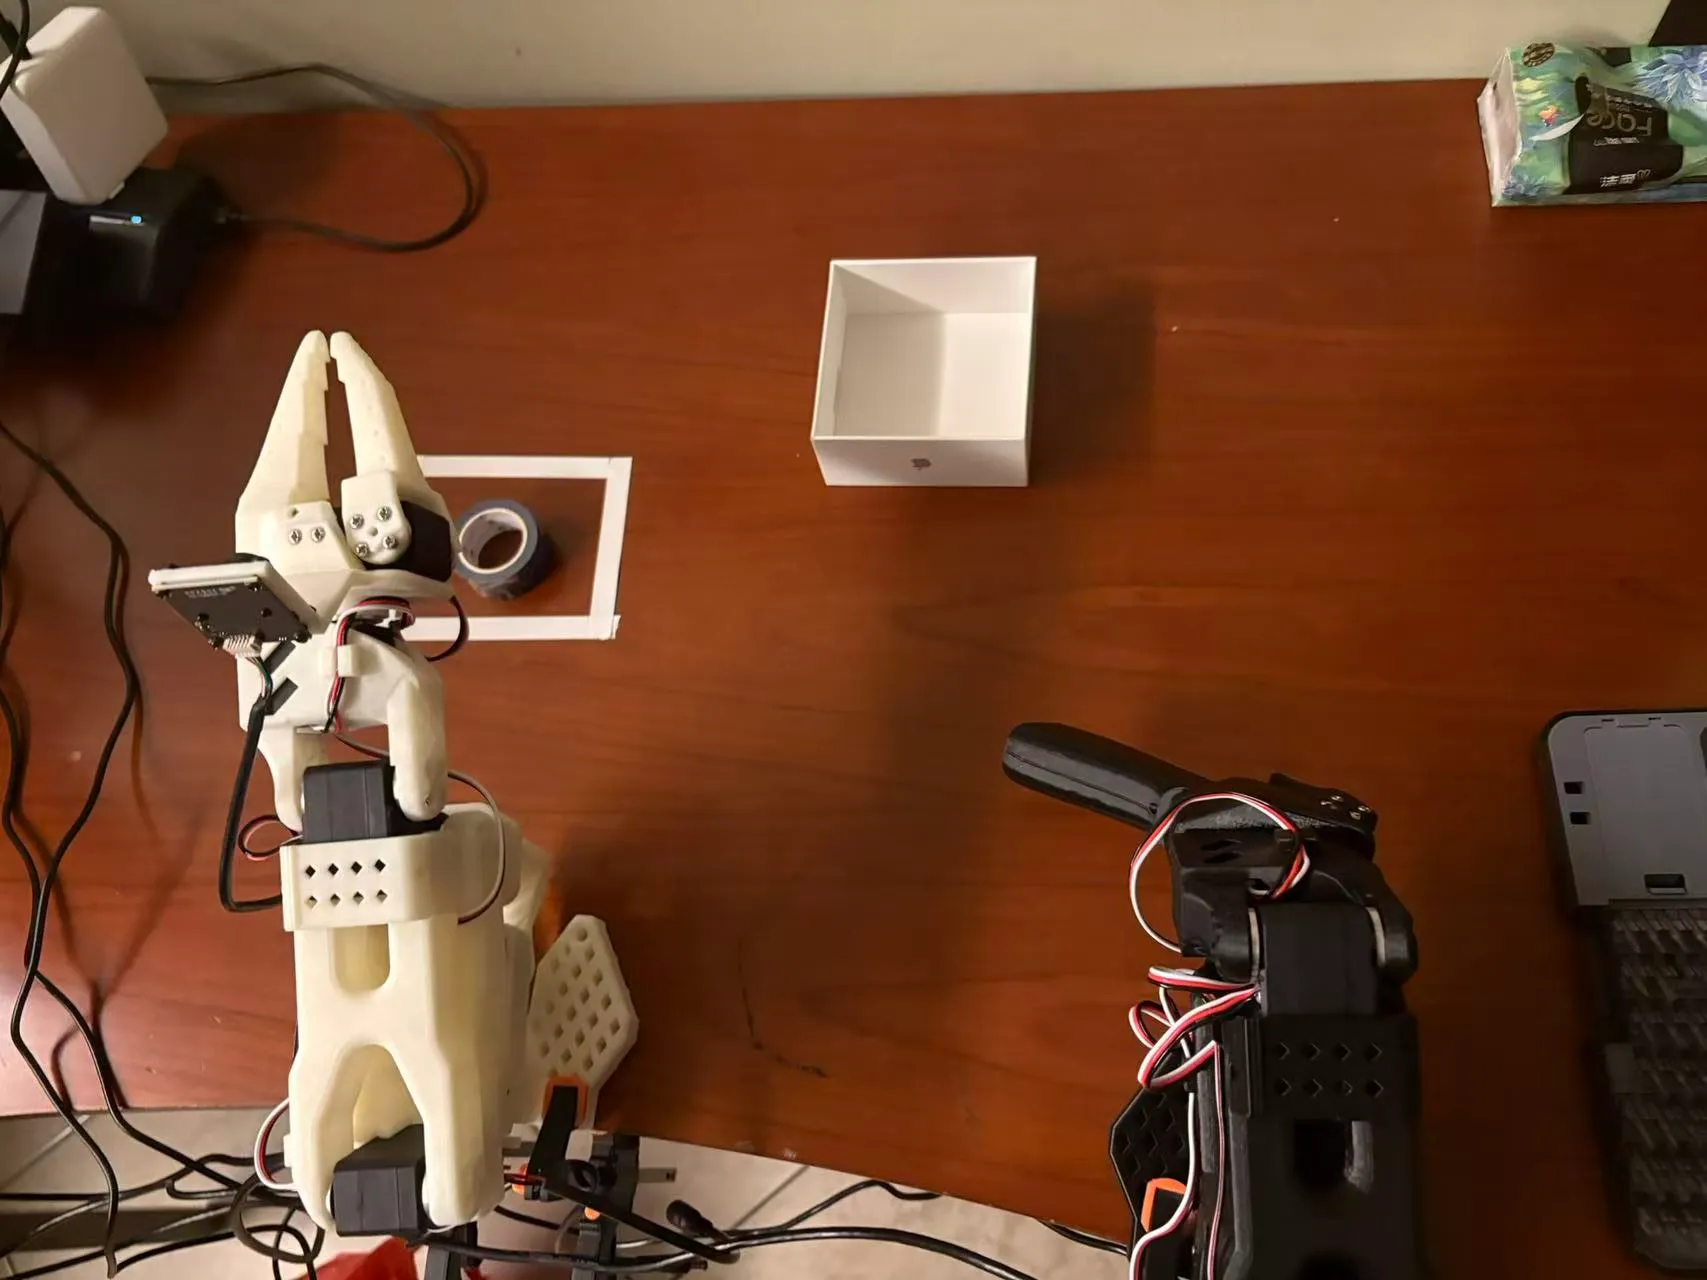
图 3:我们的 SO-101 任务场景。这个现场任务和论文里的双臂精细操作不是同一个评测协议。
这次一共录了 50 条真机示教,其中 45 条用于训练,5 条留作评估。数据包含 18,000 帧,时长 600 秒,采集频率 30 FPS。相机是单腕部相机,视频为 640×480 的 H.264;状态和动作都是 6 维,对应肩旋、肩抬、肘、腕俯仰、腕旋和夹爪。
数据 QA 也做了基本检查。索引和时间戳连续,没有空值,视频能够正常解码,解码出的帧数和记录行能对上。这些检查不能证明示教质量足够好,但至少可以先排除一批录制和对齐问题。
50 条示教的接触表能让人直观看到模型究竟见过什么。它不是成功率图,也不能单独证明任务结果,只是把每条 episode 的采样画面排在一起,作为数据分布的一份观察记录。
展开查看 50 条示教接触表

图 4:最后一次 ACT 重训的 50 条示教接触表。每一行对应一条 episode 的若干采样画面。
训练配置
训练跑在 LAB-2 的 RTX 3090 上,保存了 2K、4K、6K、8K、10K 和 12K 的 checkpoint。原计划到 30K steps,但留出损失在 6K 之后连续多个检查点没有刷新,所以完整保存到 12K 后提前停止。
| 项目 | 这次训练 |
|---|---|
| Policy | ACT / ResNet-18 |
| 参数量 | 51,597,190,约 51.6M |
| Batch size | 8 |
| Learning rate | 1e-5 |
| Seed | 42 |
| Chunk size | 100 |
| 训练 / 留出 | 45 / 5 episodes |
| Decoder layers | 1,来自实际保存配置 |
论文表里的 decoder 是 7 层,hidden 是 512,feed-forward 是 3200。我们这条 LeRobot/SO-101 训练线实际保存的是 1 层 decoder。因此,这个 51.6M 参数的单臂模型不是论文约 80M 双臂配置的同构复现。decoder 少了 6 层,理论上可能会影响复杂动作的表达能力,但这次没有做固定其他变量的 1 层和 7 层对照,不能把真机表现直接归因到这一项。
统一离线比较得到的结果如下:
| Step | 过程中的 eval loss | 留出归一化 MAE | 任一关节超训练范围 |
|---|---|---|---|
| 2K | 0.3714 | 0.402574 | 27.77% |
| 4K | 0.3578 | 0.397638 | 18.68% |
| 6K | 0.3543 | 0.390420 | 23.72% |
| 8K | 0.3882 | 0.433116 | 29.61% |
| 10K | 0.3749 | 0.416488 | 34.70% |
| 12K | 0.3831 | 0.423983 | 22.35% |
所以这一轮优先考虑的是 6K checkpoint。更准确地说,它在统一的 512 个留出锚点比较中拿到了本轮最低的全段归一化 MAE。这个结论只针对离线候选排序,不等于 6K 已经通过真机任务验收,更不能从中推出模型具备泛化能力。
频率
论文里的 ALOHA 使用 50 Hz 的机器人控制和遥操作时间基准,相机大约是 30 FPS。我们这条 SO-101 线按 30 Hz 采集和推理,是为了让相机、状态、动作、记录和控制链路保持同一个可检查的时间协议。30 Hz 不是 ACT 的硬性要求。
因此,chunk_size=100 在我们这里对应大约 3.33 秒的动作预测跨度;如果按 50 Hz 运行,同样的 100 步只有 2 秒。频率变化会连带影响动作速度、释放时机和重新规划间隔,不能只改一个数字就把它当成论文复现。
真机测试
在 6K 候选上的一次受保护 15 秒测试中,记录到 450 / 450 个控制周期完成,控制频率为 30 Hz,每个周期输出 [1, 100, 6] 的动作块。平均推理延迟是 18.75 ms,P95 是 29.20 ms;出现了 14 次 deadline miss,但没有周期超出训练动作范围,也没有触发 30° 安全中止。
这组数据能说明控制链路、实时性检查和动作范围保护跑通了。它不能单独说明蓝色胶带已经被完整抓起并放进托盘。原始报告也明确写了,完整成功仍然需要现场观察或视频标注。
这次结果和之前那条 9 条清洗示教、7K checkpoint、固定场景 8/10 的实验线要分开。前一次是已经做过完整固定场景闭环评测的早期实验;这一次是 50 条示教重训后的离线候选,加上一轮受保护的控制测试。两组数字不能拼成一个更大的成功率。
重训之后
以前看到 chunk_size=100,我容易把它当成一个模型超参数。真正部署时才发现,它同时规定了模型输出的时间尺度。模型一次预测 100 步,系统却只执行第 1 步,后面 99 步被直接丢掉,模型学到的连续过程就会被部署配置切碎。真机抽动时,先查动作块怎样交接、多久重新规划,比立刻增加训练步数更有用。
离线 loss 也只能回答一部分问题。6K 的留出归一化 MAE 比 12K 好,说明它在这套比较里更值得优先拿去测;它没有回答相机视角变了会怎样,也没有回答夹爪的时相是否可靠。真实机器人还会把起始姿态、关节延迟、物体复位和动作限幅一起带进来。
50 条示教比 9 条多很多,但它们仍然来自一个任务和相近的场景。数据量增加当然有帮助,前提是 episode 边界干净、相机输入稳定、物体复位没有混进任务,而且起始状态确实有一些变化。多录几条相似的轨迹,不会自动带来泛化。
最后还要把复现范围说清楚。这次验证的是:在 SO-101、单腕部相机、6 维动作、30 Hz 和当前数据协议下,LeRobot 的 ACT 训练与推理链路可以运行,并且能对离线 checkpoint 和控制过程做追溯检查。它没有证明这个 51.6M 单臂配置等同于论文里的双臂配置,也没有证明固定场景结果能推广到陌生位置、物体、光照或背景,更没有证明它具备语言条件的 VLA 能力。
我怎么记 ACT
训练时,模型拿一帧观察和同一条 Episode 里的未来动作,先从示教动作中得到 z,再结合视觉和关节状态预测未来动作块。执行时,未来示教动作不存在了,模型用当前观察和 z=0 预测动作块,再把不同时间针对同一执行时刻的预测做时间集成。
我现在觉得 ACT 最值得留下的,不是某个看起来很神奇的模块,而是它把几个容易被分开讨论的问题放到了一起:示教怎么采,动作按什么单位学习,预测多久更新一次,离线指标能证明到哪里,最后真机上又该怎样保护和验收。
对我们自己的 SO-101 项目来说,读论文的收获也不只是知道怎样训练 ACT。更重要的是,看到一个离线数字、一个 checkpoint 或一次真机测试时,能分清它们各自证明了什么,还没有证明什么。
原论文:Learning Fine-Grained Bimanual Manipulation with Low-Cost Hardware · HTML 版本 · 官方代码 · ALOHA 项目主页