为什么做这个项目
RSS 的问题不是没有信息,而是信息太多。订阅源逐渐增加后,每天都会堆出大量文章;只看标题容易漏掉真正有价值的内容,逐篇打开又很耗时间。
JunkFilter 做的是一件很具体的事:先把订阅内容稳定地收进来,再让模型按“新颖度、深度和个人偏好”做第一轮筛选。 用户最后看到的不是一条未经处理的信息流,而是一组已经完成去重、摘要和分级的候选文章。
它不是一个只展示 Prompt 的演示。项目包含 RSS 抓取、消息队列、状态持久化、LLM 评估、自然语言工具调用、网页阅读器和 Telegram Bot,完整跑通了从数据进入到结果消费的链路。
系统是怎样串起来的
系统被拆成三条相对独立的链路:
- 采集链路:Go 服务定时抓取 RSS,在入队前完成内容清洗和多级去重。
- 评估链路:Python Consumer 从 Redis Stream 取出文章,通过 LangGraph 状态机调用模型,解析结果后写入 PostgreSQL。
- 交互链路:网页和 Telegram Bot 调用 ReAct Agent 查询文章、管理订阅与更新偏好;高价值内容也可以主动推送。
Go 和 Python 之间没有直接互相等待。抓取速度和模型推理速度差异很大,Redis Stream 在中间承担缓冲和消息重投,避免某次模型调用变慢时拖住整个抓取任务。
为什么是 Go + Python
Go 负责 RSS、HTTP API 和并发抓取,Python 负责 LLM、LangGraph 和 Agent 工具。这样拆分并不是为了增加技术栈,而是让两侧各自处理更擅长的任务。对于个人部署,Redis Stream 已经能够完成解耦、消费者组和 pending 消息恢复,没有再引入 Kafka。
抓取:先在便宜的地方过滤
抓取服务当前通过配置控制并发 worker,默认配置为 20 个 worker、30 分钟调度一次。不同订阅源还可以维护自己的抓取间隔,不需要为每个源单独启动定时器。
一篇文章进入评估队列前,会依次经过:
- 内容长度检查,过滤只有预告或极短摘要的条目;
- 来源级作者白名单、黑名单;
- URL 与内容哈希去重;
- 正文截断,避免单篇文章无限占用上下文;
- PostgreSQL 唯一约束兜底。
多级去重真正解决了什么
这里的目标不是追求一个好看的“去重准确率”,而是把不同代价的检查放在合适的位置。
| 层级 | 作用 | 边界 |
|---|---|---|
| Bloom Filter | 进程内快速判断“是否可能见过” | 有假阳性,不能单独作为最终依据 |
| Redis | 对 Bloom 命中的内容做精确确认,并设置 7 天 TTL | 需要一次网络访问 |
| PostgreSQL UNIQUE | 在写入时处理并发竞态,保证最终唯一 | 作为最后防线,不承担高频预检查 |
Bloom Filter 命中后仍会查询 Redis;只有 Redis 也确认存在,才把文章当作重复内容。这样避免了把 Bloom Filter 的假阳性直接变成内容丢失。
评估:把一次模型调用变成可恢复的状态机
模型需要输出新颖度、内容深度、处理决策、摘要、理由和关键概念。真实运行时,第三方兼容接口并不总会返回稳定的 JSON:可能混入 Markdown 代码块,也可能把正文放在推理字段里,或者在请求中途失败。
因此评估过程被组织成一个小型 LangGraph:
读取文章
   ↓
注入全局或来源级偏好
   ↓
调用模型并收集完整输出
   ↓
解析、校验结构化字段
   ├── 成功 → 写入 evaluation
   └── 失败 → 有限次数重试 → 标记失败状态
Consumer 使用 Redis Stream 消费者组。消息在评估和数据库写入完成后才 ACK;如果进程中途退出,未完成的消息仍留在 pending list 中,重启后可以继续处理。数据库里的 eval_attempts 则限制失败文章的重试次数,避免坏数据反复占用队列。
偏好不靠微调
用户可以直接说“更关注系统设计”“不想看营销稿”。Agent 把偏好写入 PostgreSQL 的 JSONB 字段,Consumer 在下一次评估前把它追加到系统提示词中。
来源级偏好优先于全局偏好;数组字段做追加去重,分数阈值等标量字段覆盖旧值。这个方案没有把 Prompt Engineering 包装成模型训练,但它确实解决了个人偏好需要频繁变化的问题。
Agent:不是聊天壳,而是系统入口
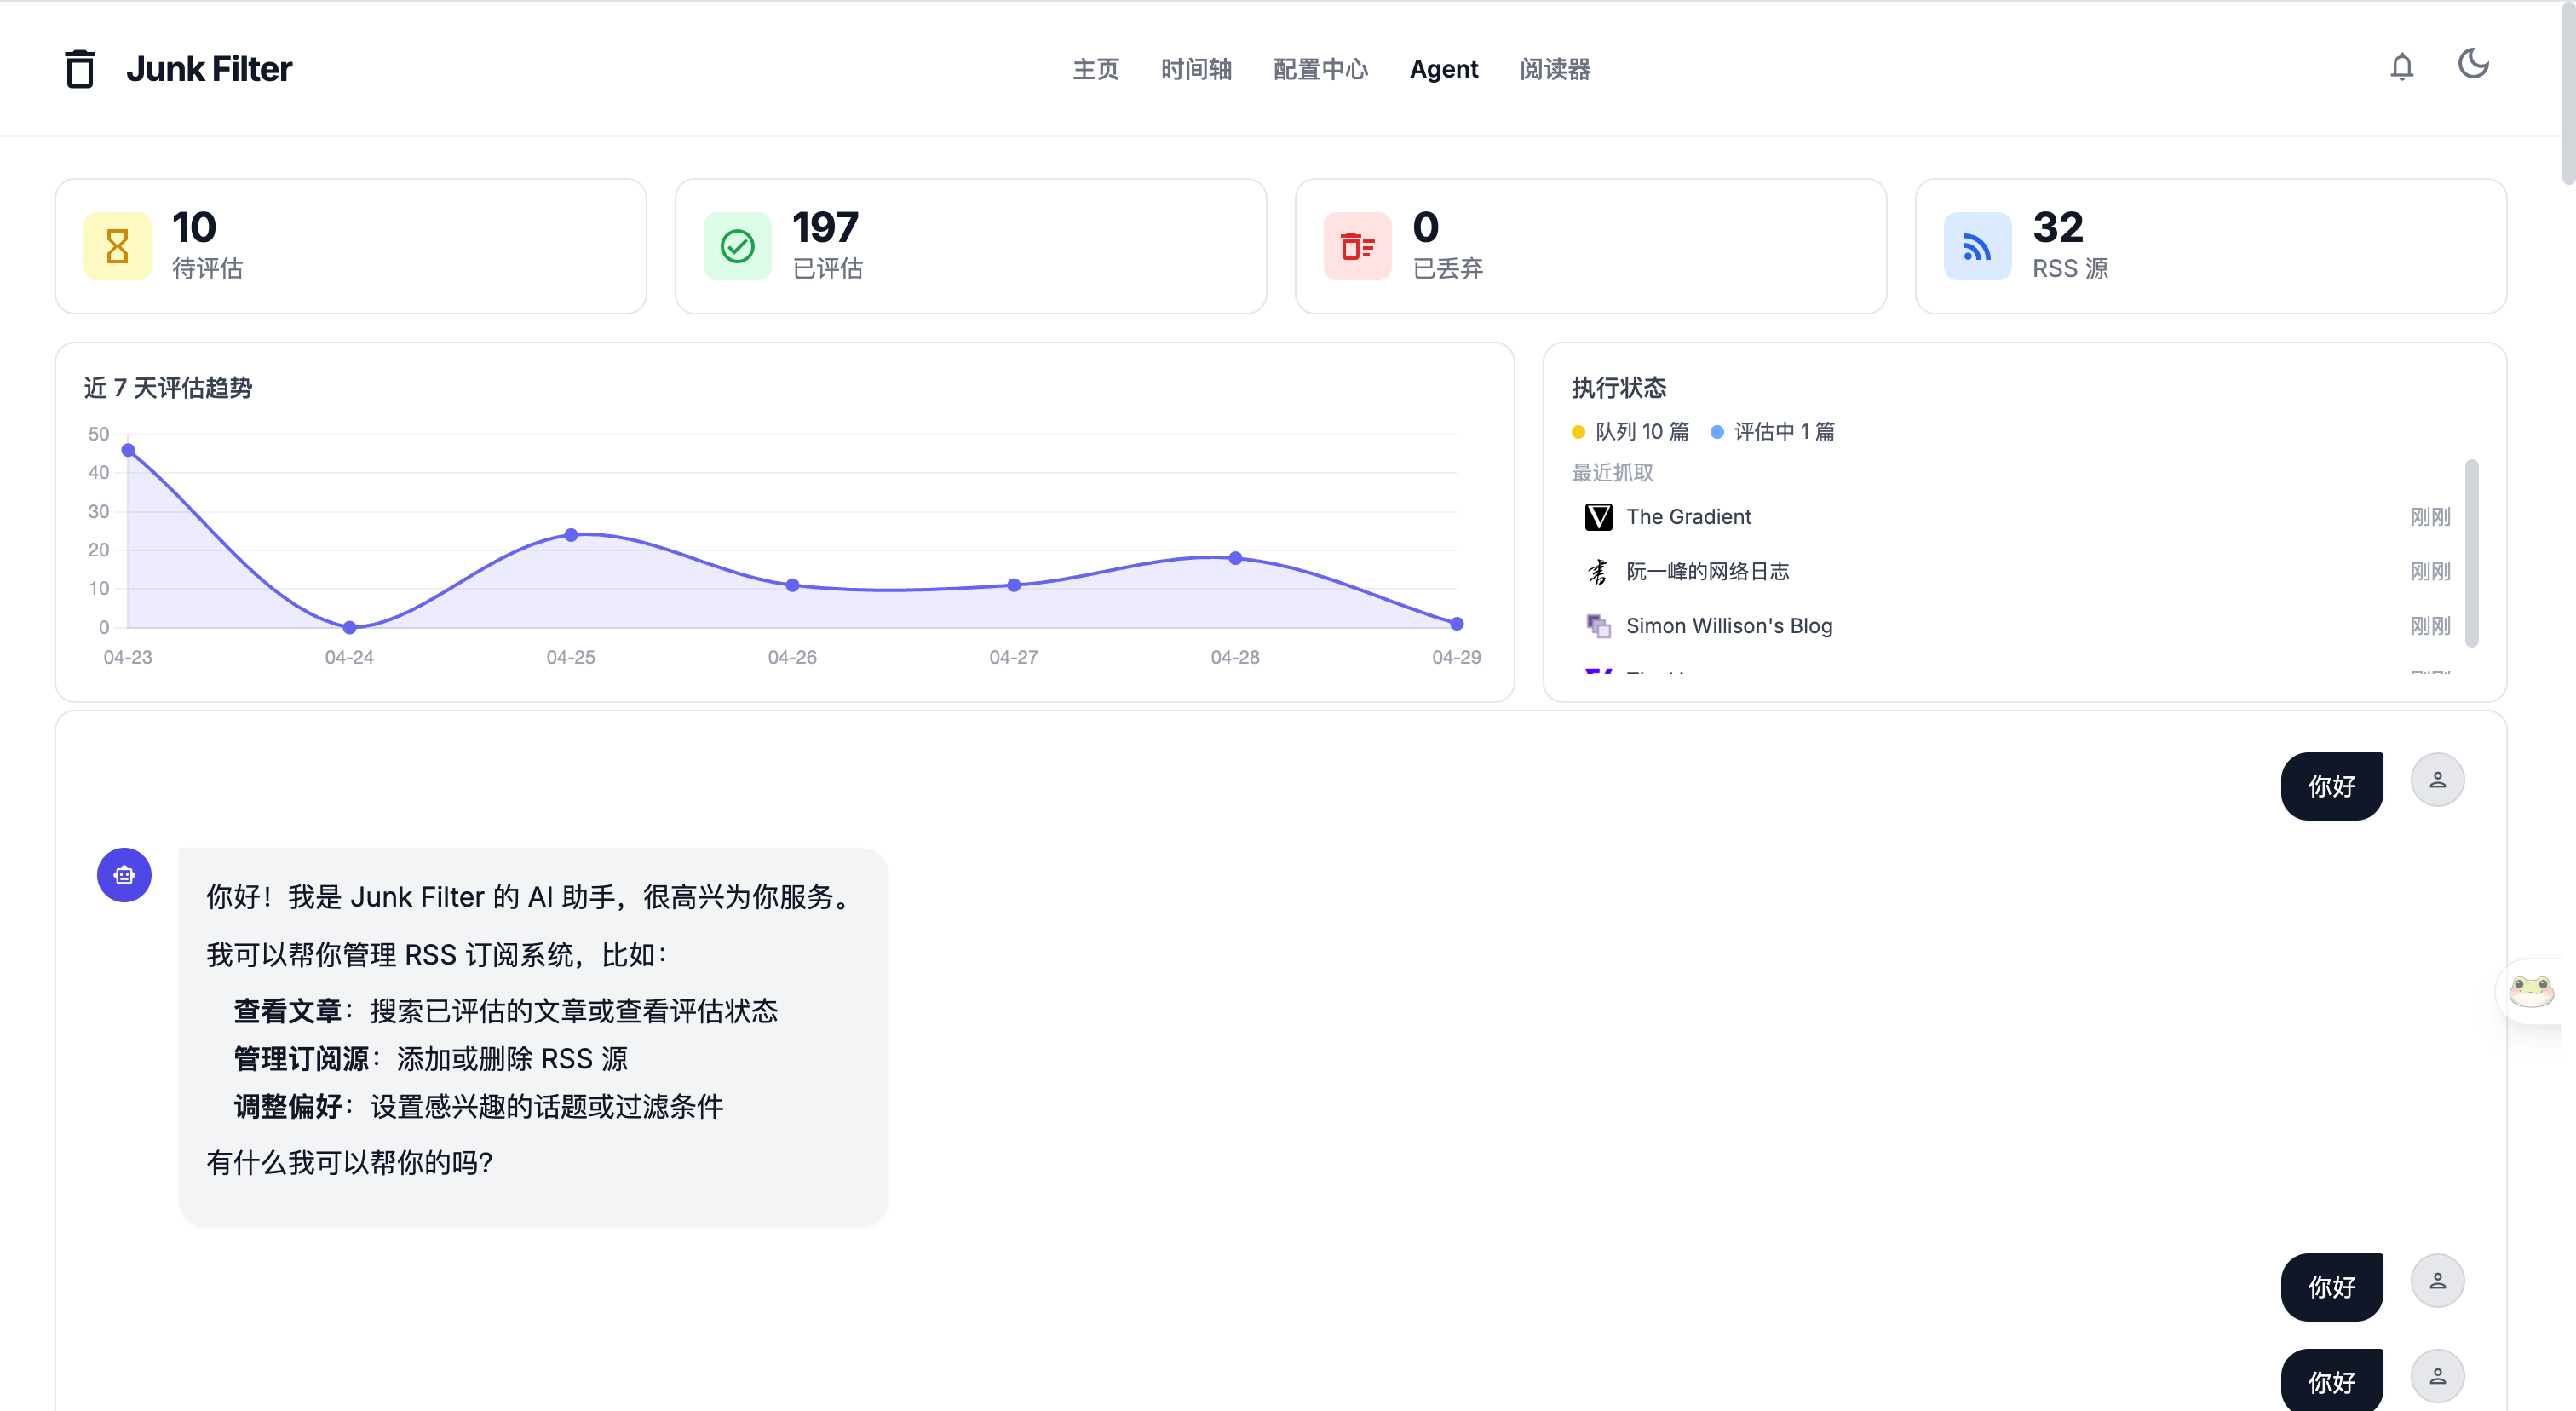
项目没有直接套用完整的 Agent SDK,而是围绕 OpenAI Function Calling 协议实现了一个受控的 ReAct 循环。每轮由模型决定是否调用工具,执行结果重新加入上下文;达到最大轮数或模型给出最终回答后结束。
目前的工具覆盖五类操作:
- 按关键词、评分、时间或决策查询文章;
- 查看评估管道状态;
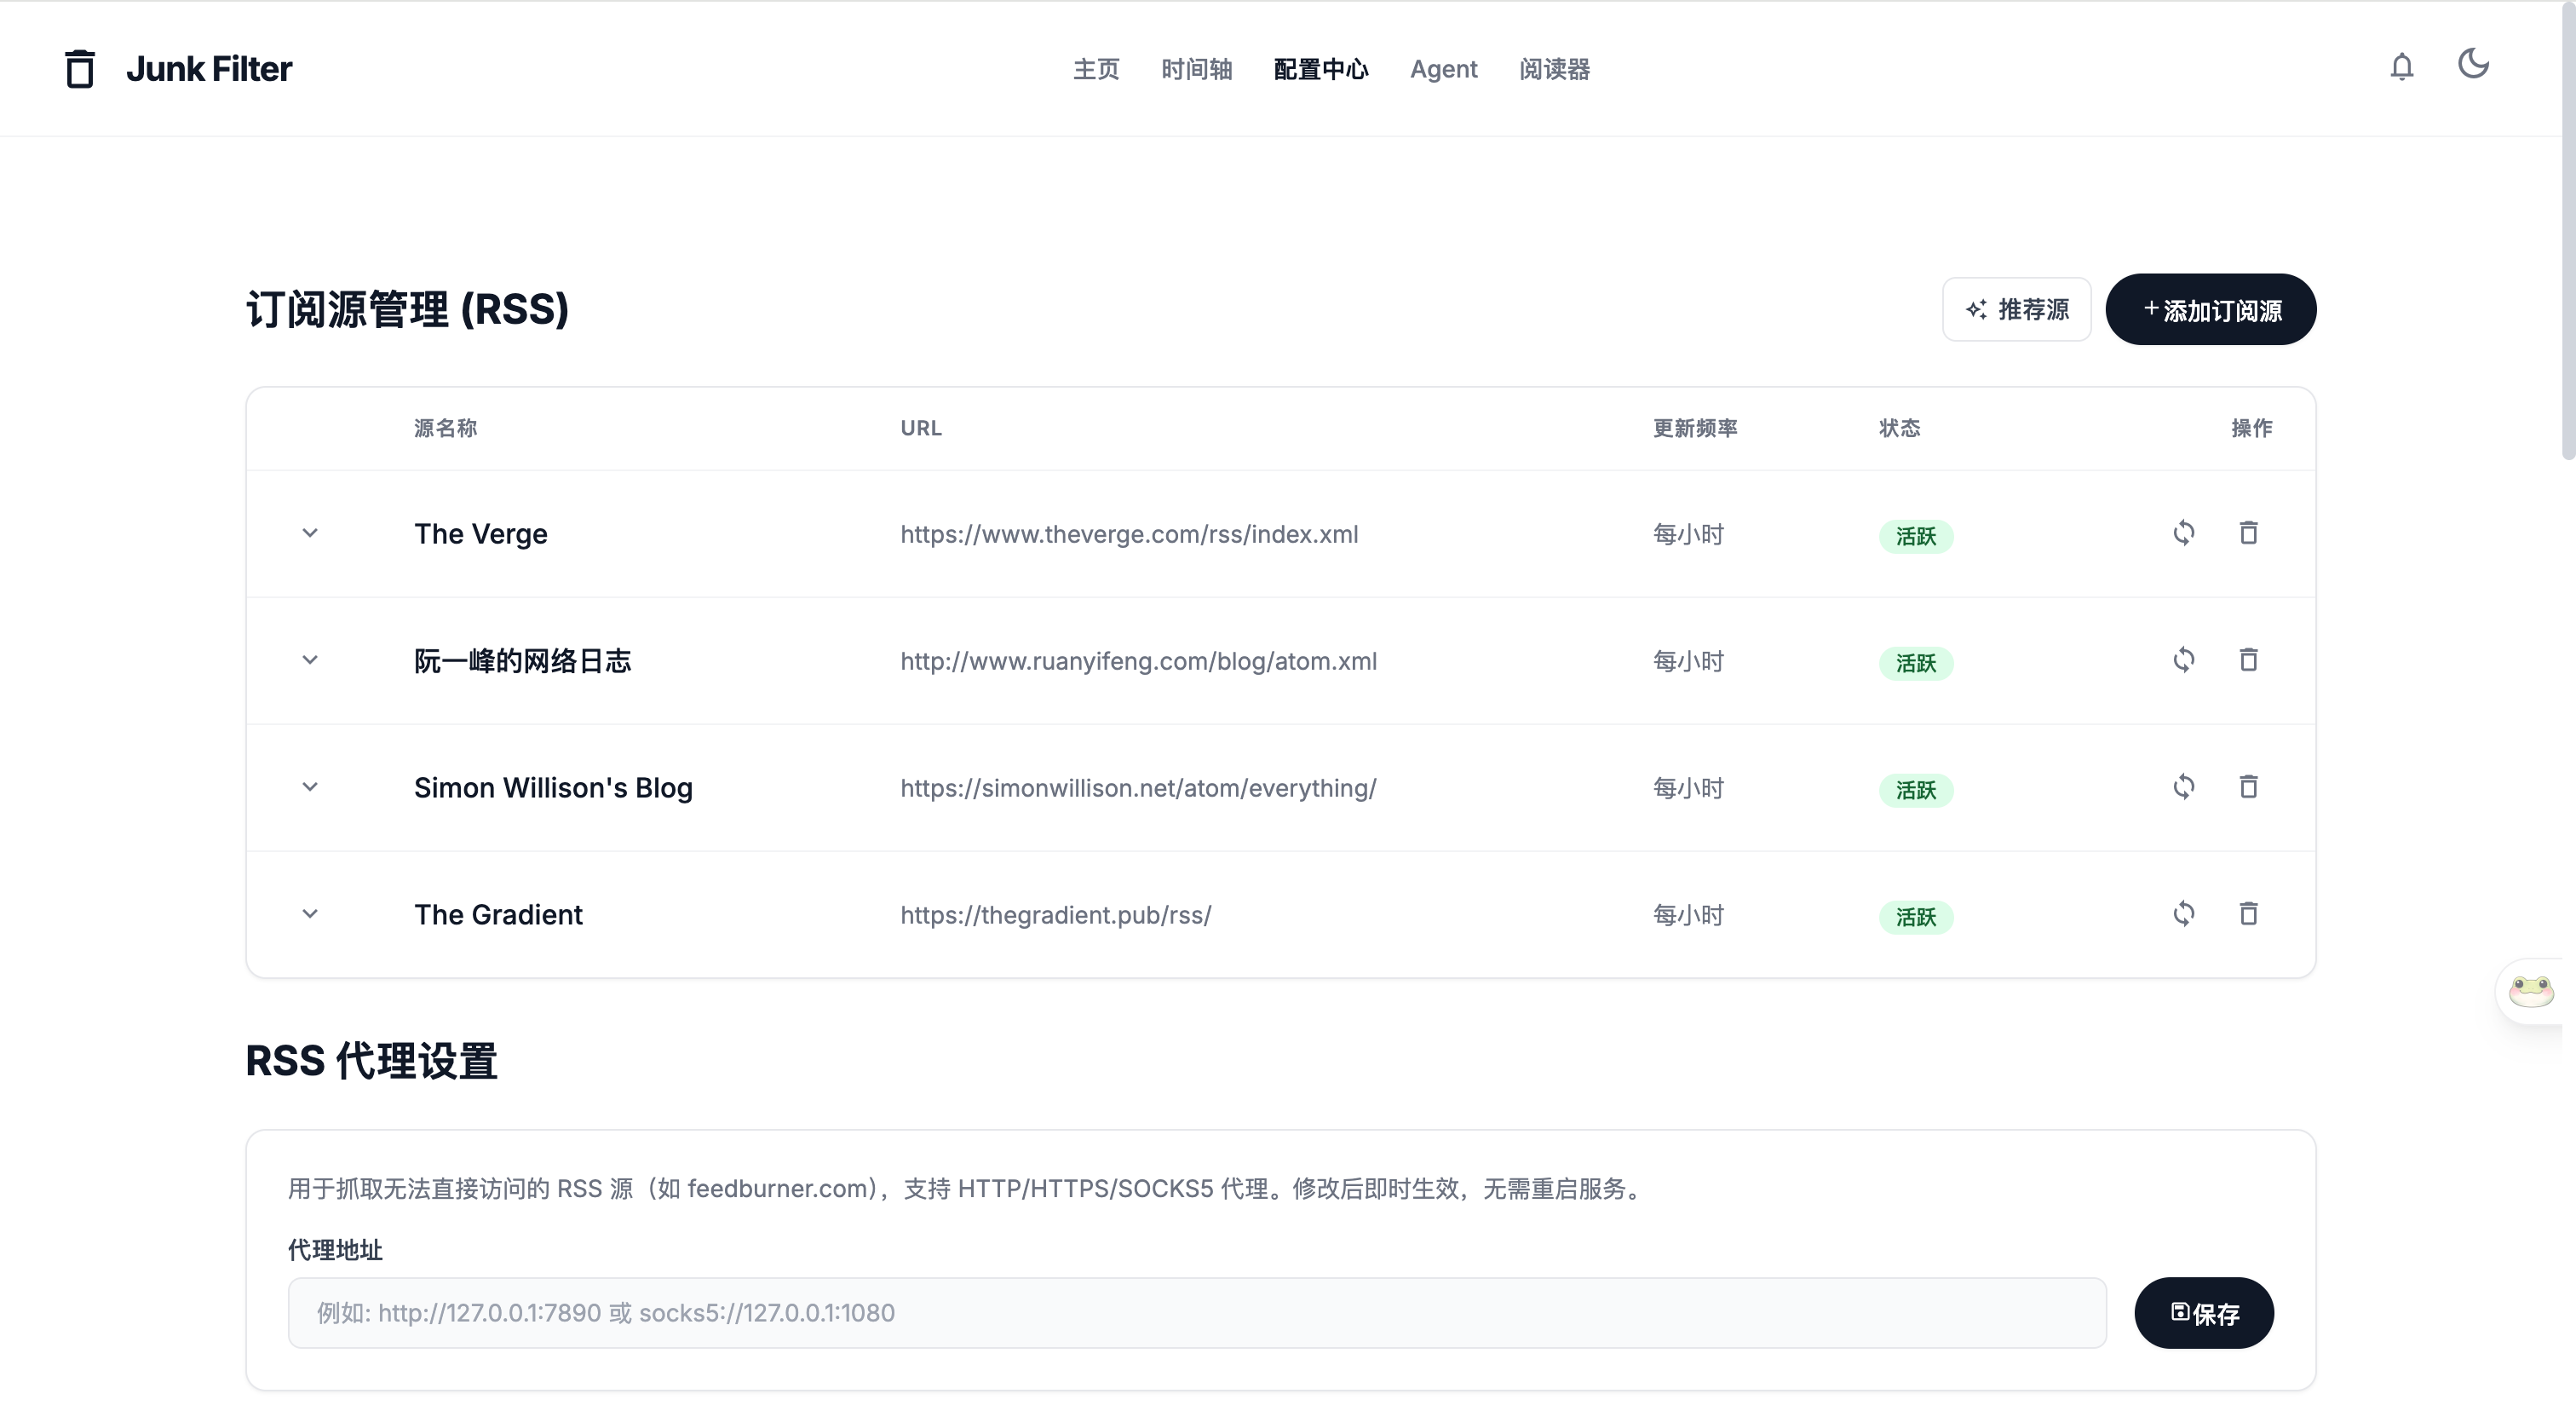
- 添加 RSS 源;
- 删除 RSS 源;
- 更新全局或来源级偏好。
前端通过 fetch + ReadableStream 消费 SSE。之所以没有直接用 EventSource,是因为对话请求需要用 POST body 携带消息和模型配置。流中除了正文片段,还会发送工具名、参数、执行结果和结束状态,页面可以把一次 Agent 执行展开给用户看。
Telegram Bot:最麻烦的不是接 API
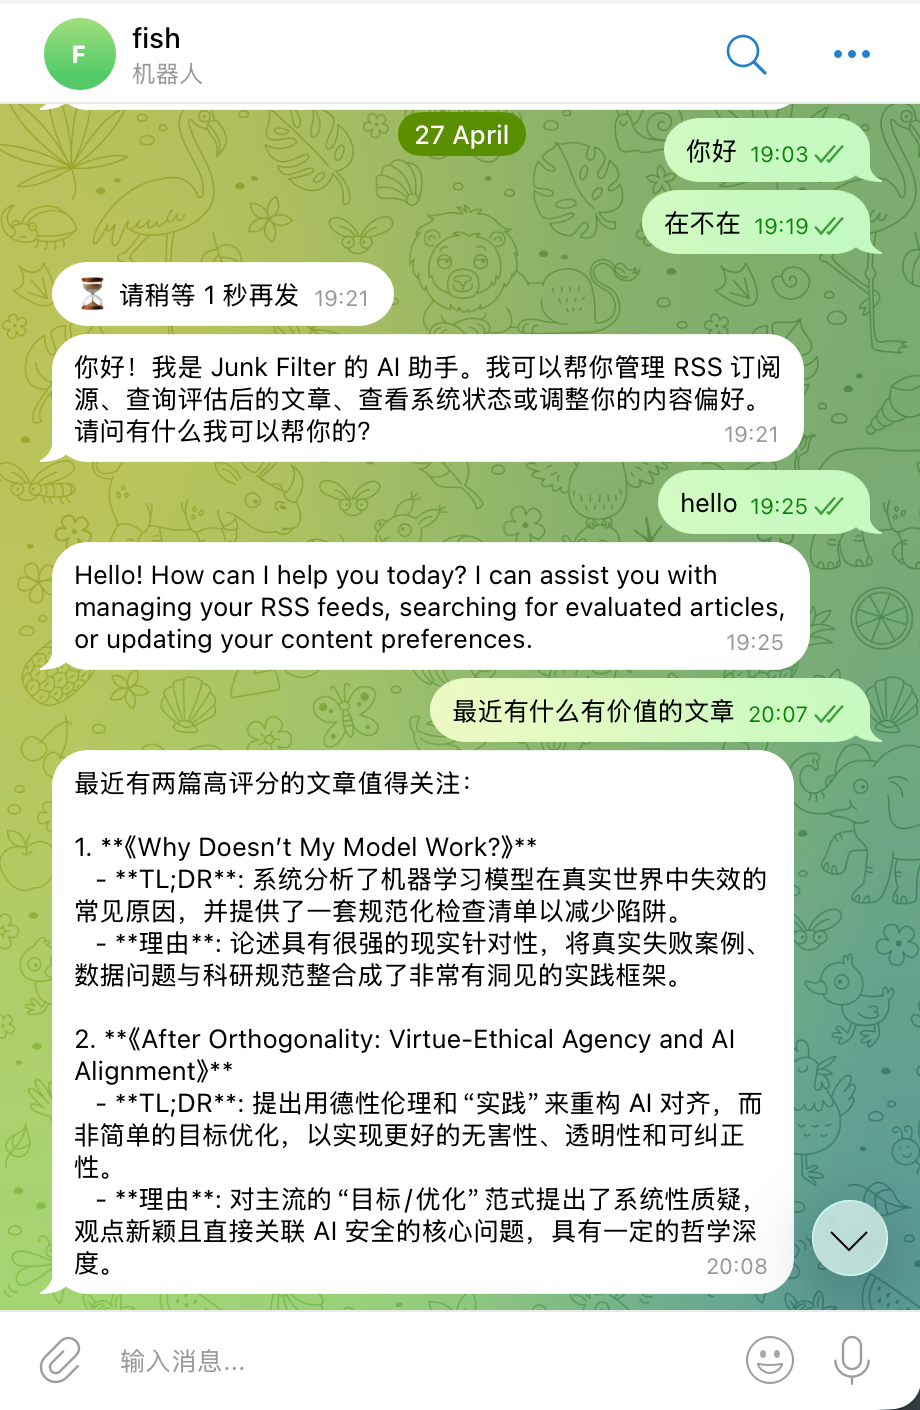
Bot 使用长轮询运行,不依赖公网 webhook。除了查询和管理订阅,它也接收高价值文章的主动推送。
实现过程中出现过一个很典型的异步问题:asyncpg 连接池在一个 event loop 中创建,却在 python-telegram-bot 启动的另一个 event loop 中使用,最终报出连接正在执行其他操作之类的错误。
修复方式不是增加锁,而是把连接池的创建放进 PTB 的 post_init 回调,让连接池与 Bot 运行在同一个 event loop 中,并在 post_shutdown 中关闭。随后又为每个用户增加独立队列,保证同一用户的多条消息串行处理,同时不阻塞其他用户。
这次排错也让我更明确了一点:asyncio 里的连接、连接池和 socket 都有自己的 loop 生命周期,跨 loop 共享并不是普通的并发访问问题。
页面与使用方式
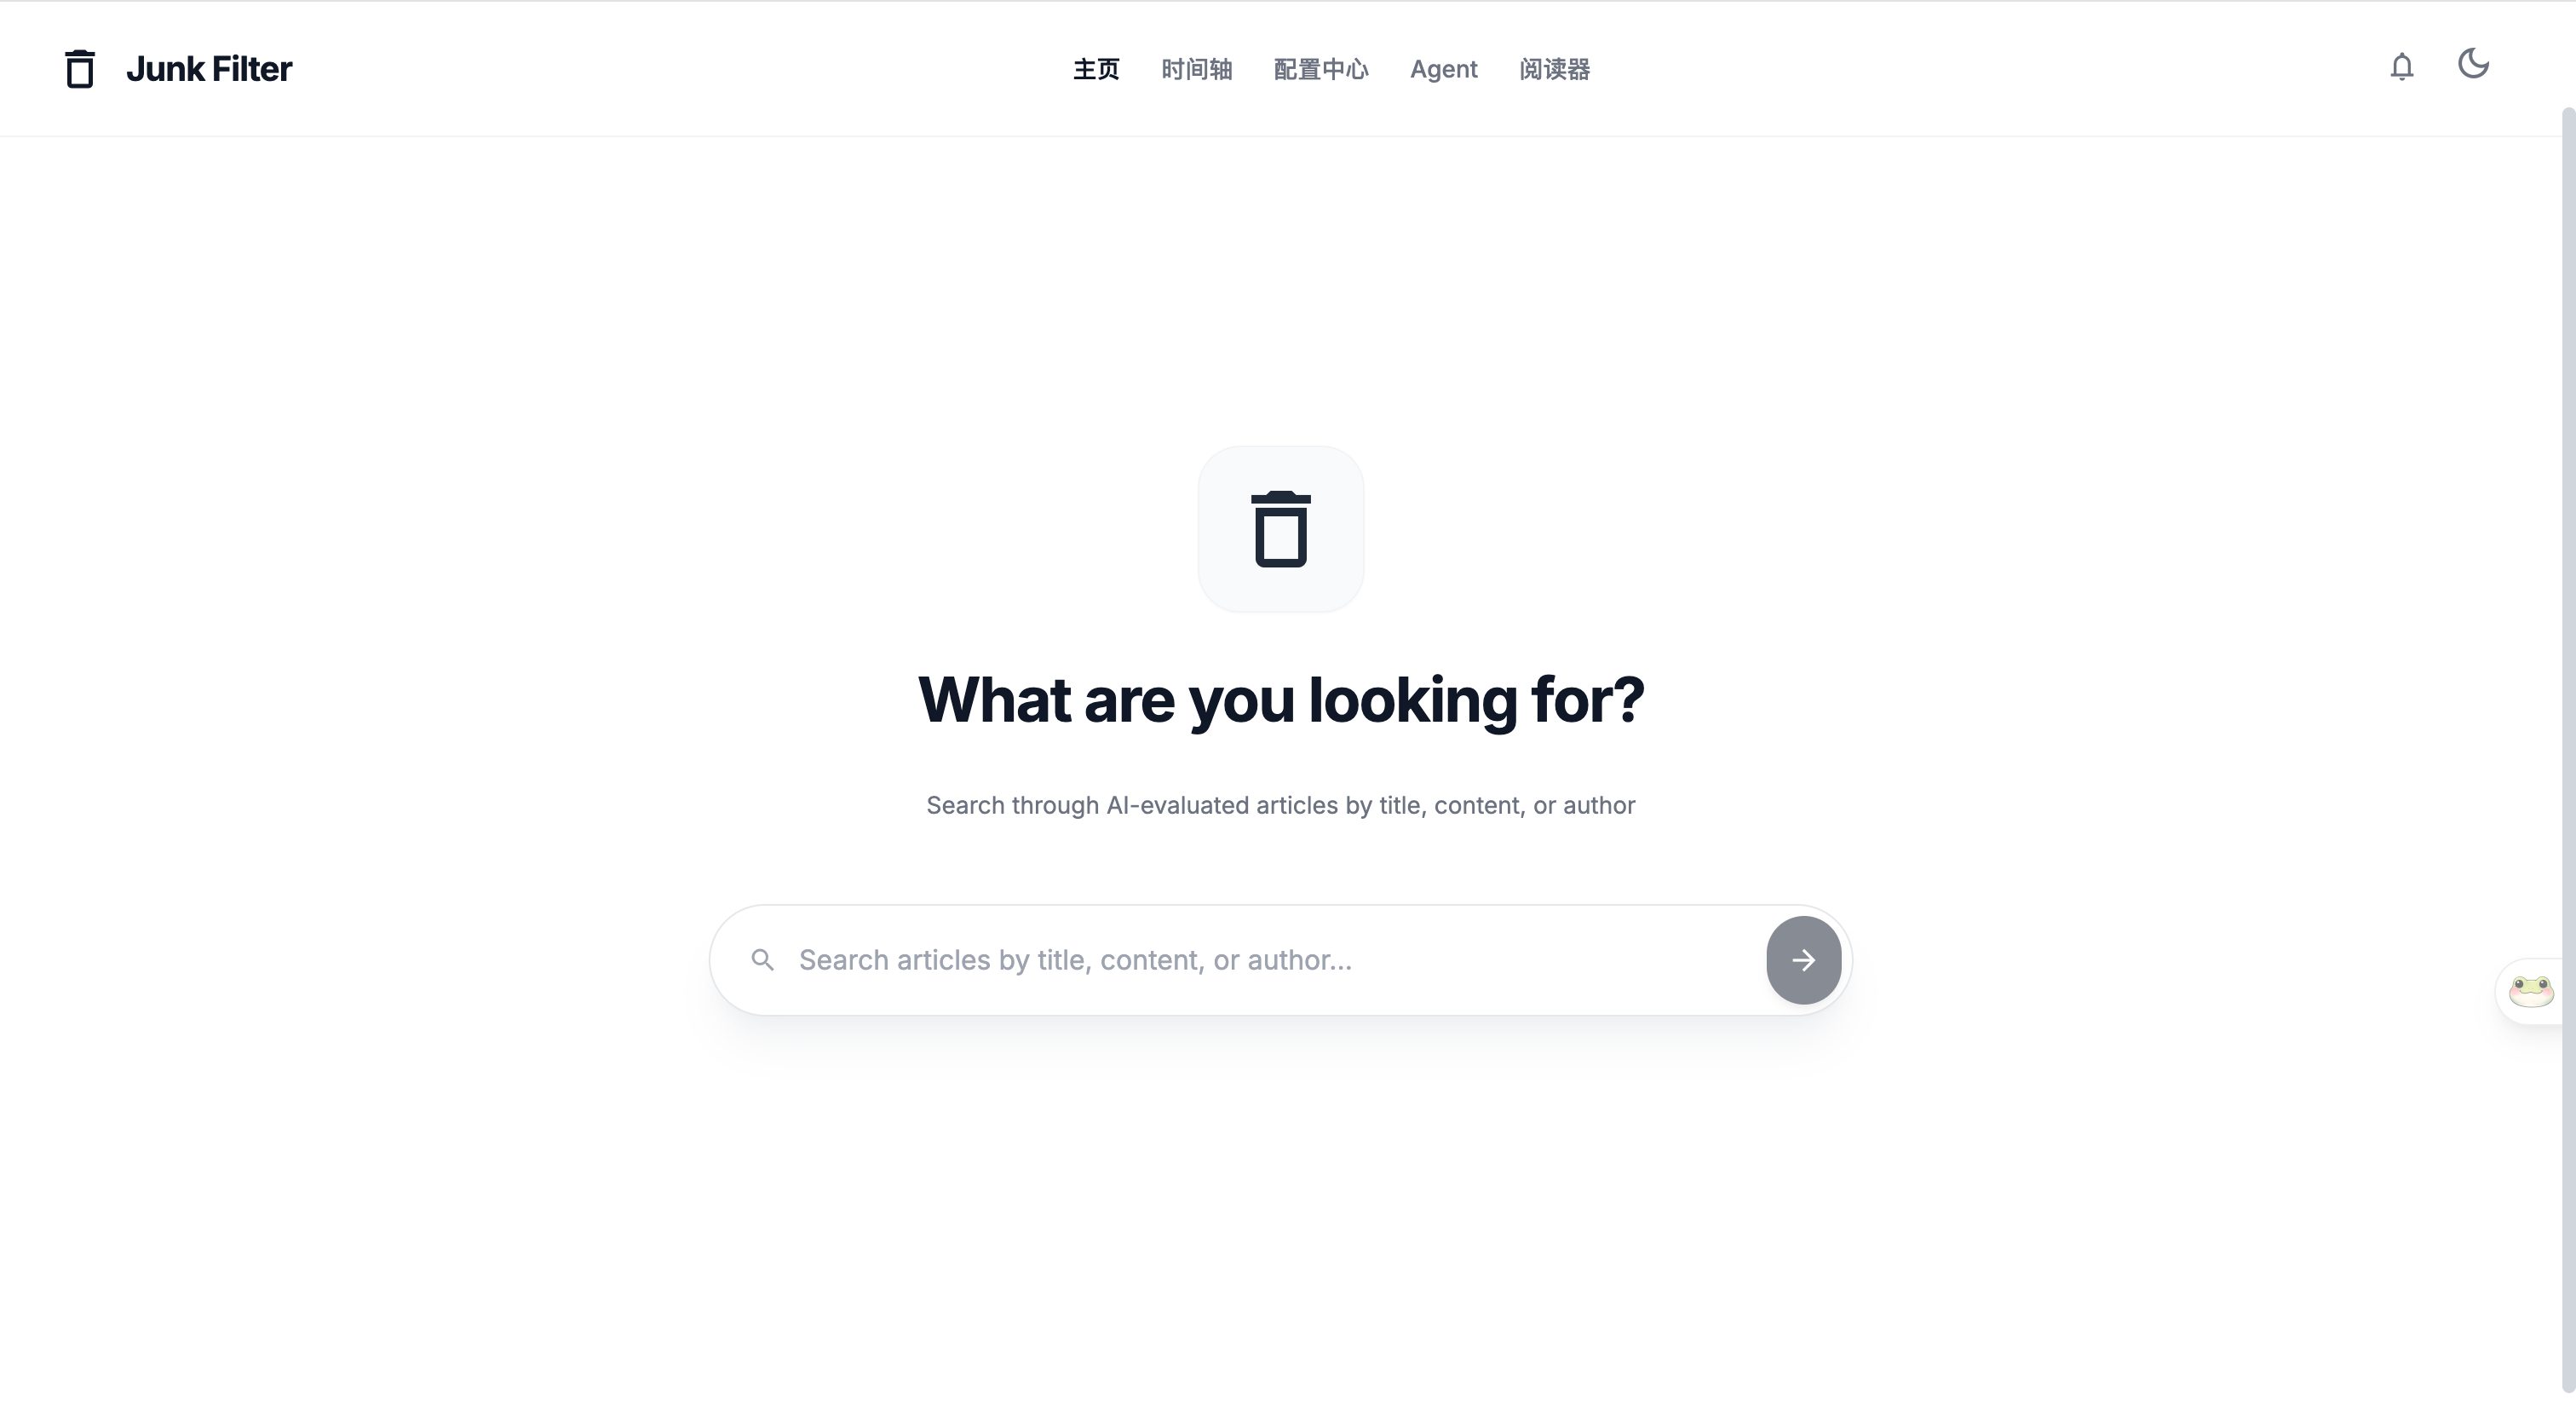
首页:统一搜索入口
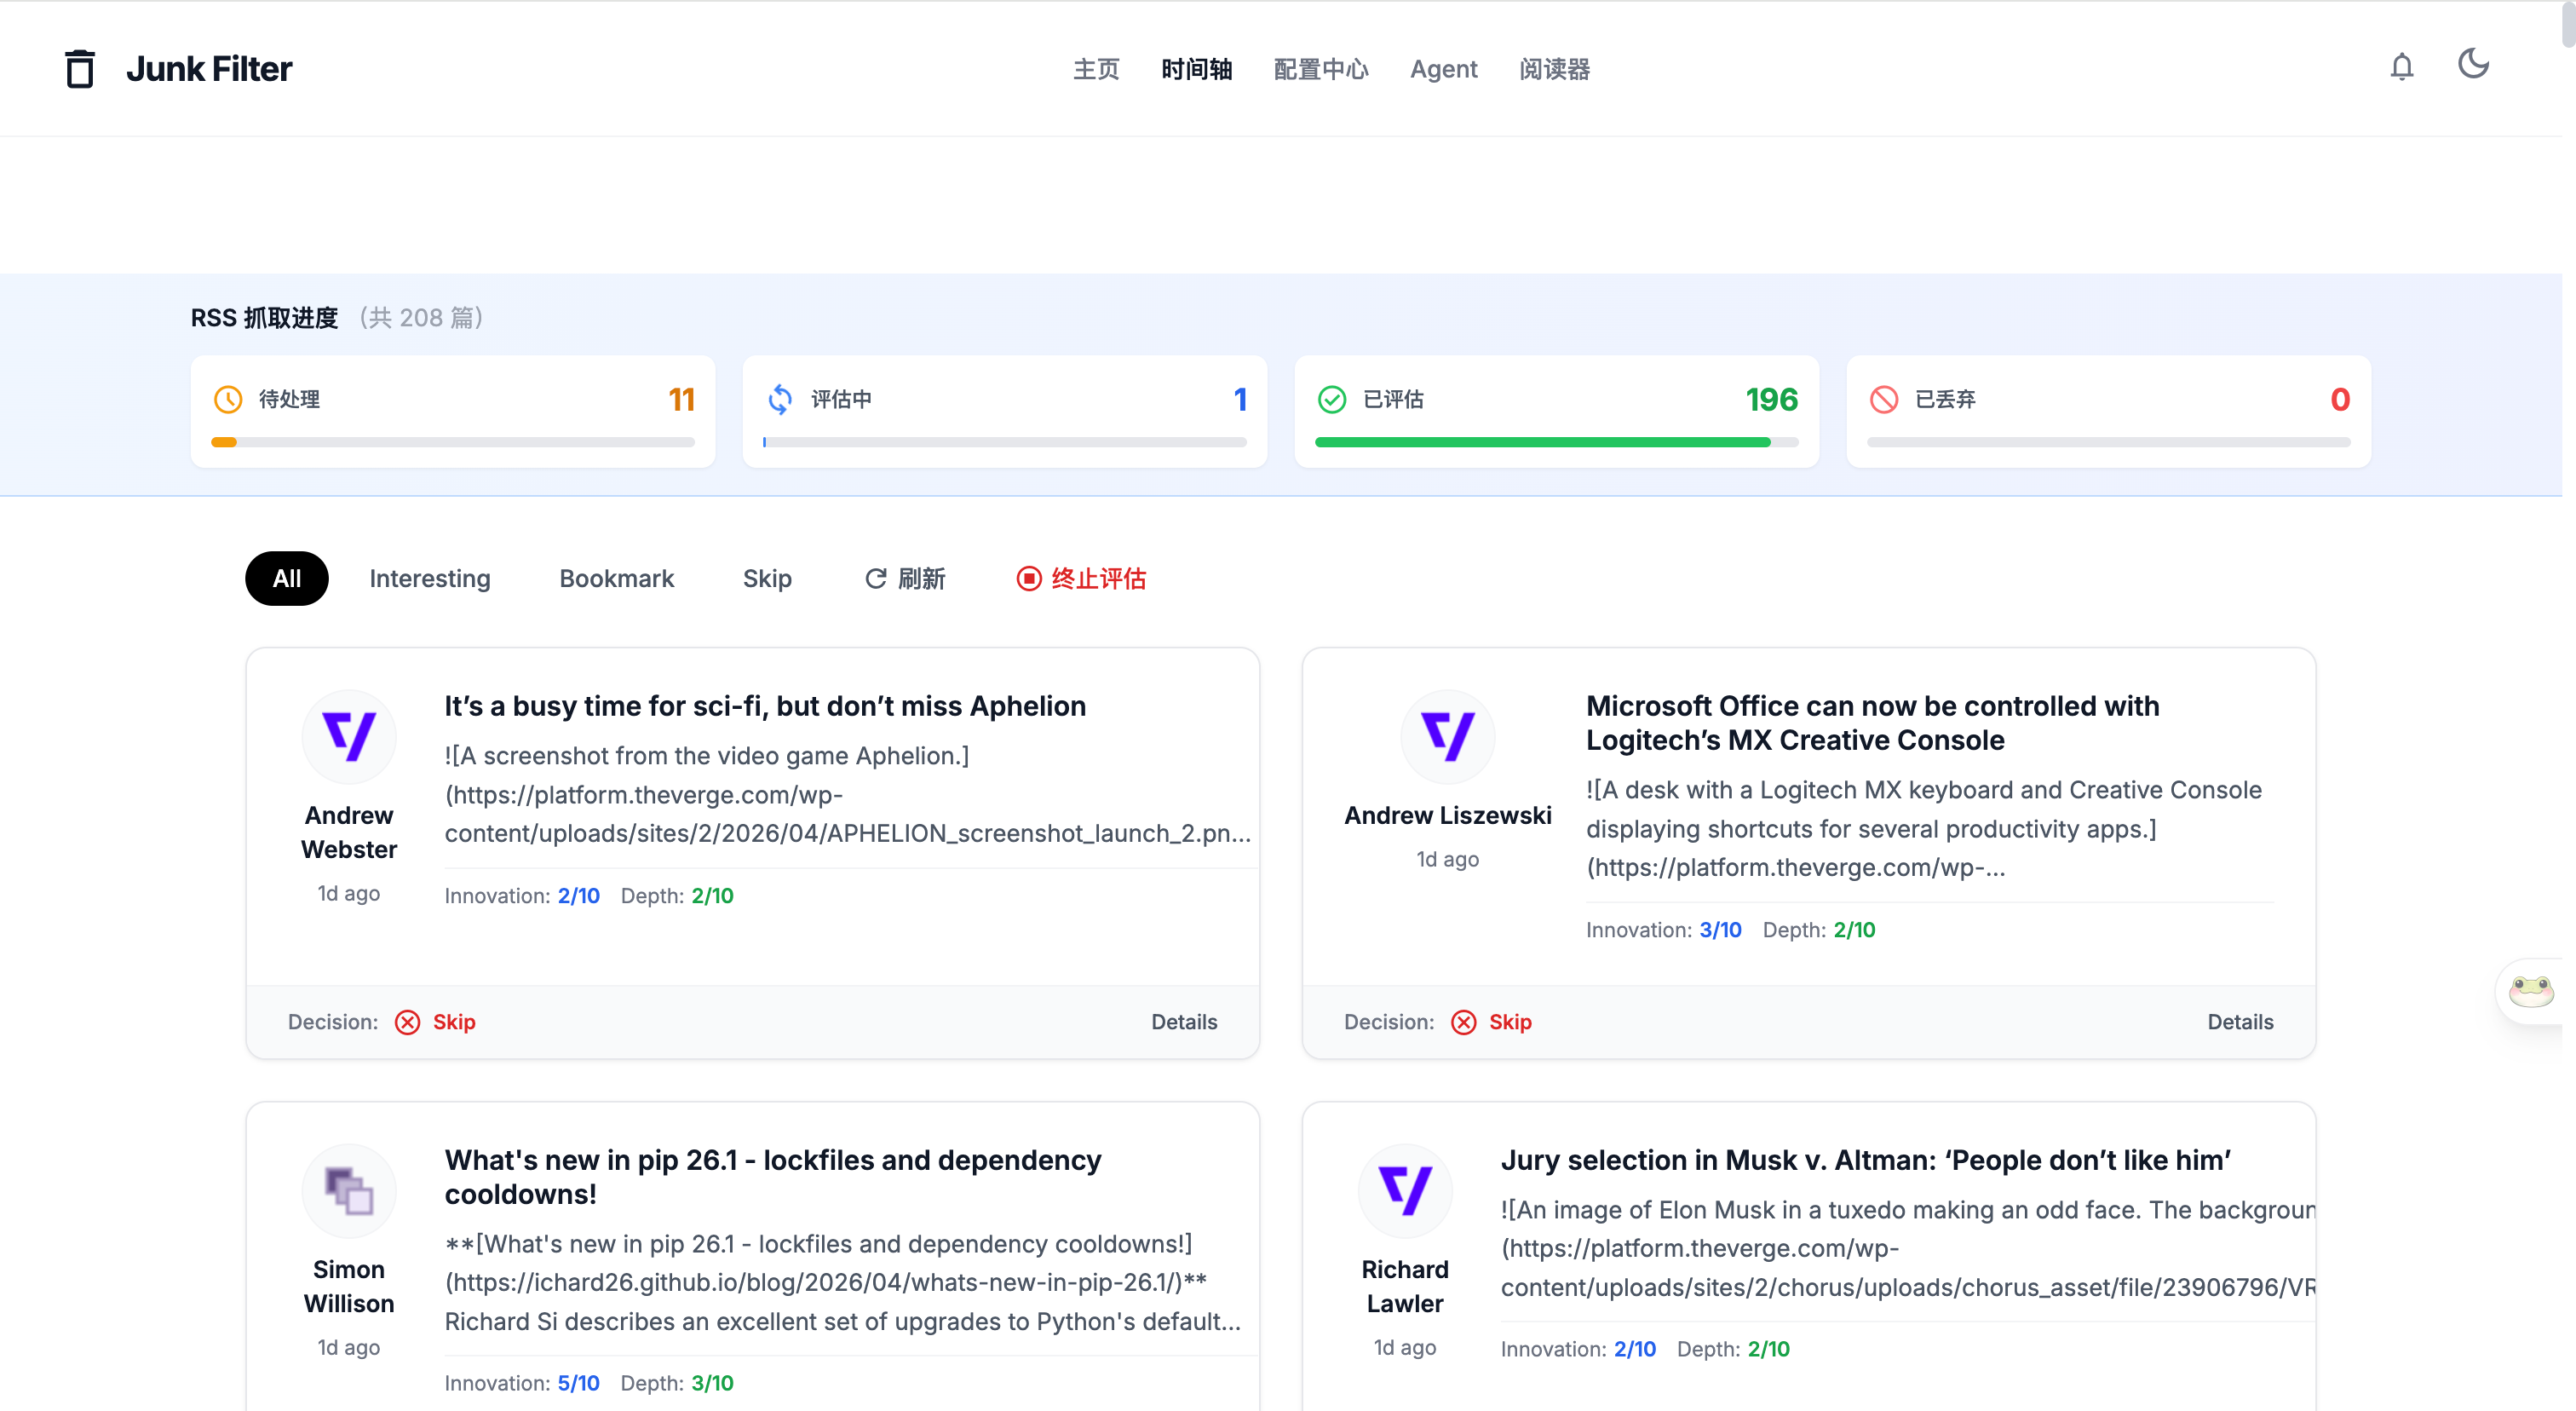
时间线:查看评估进度和结果
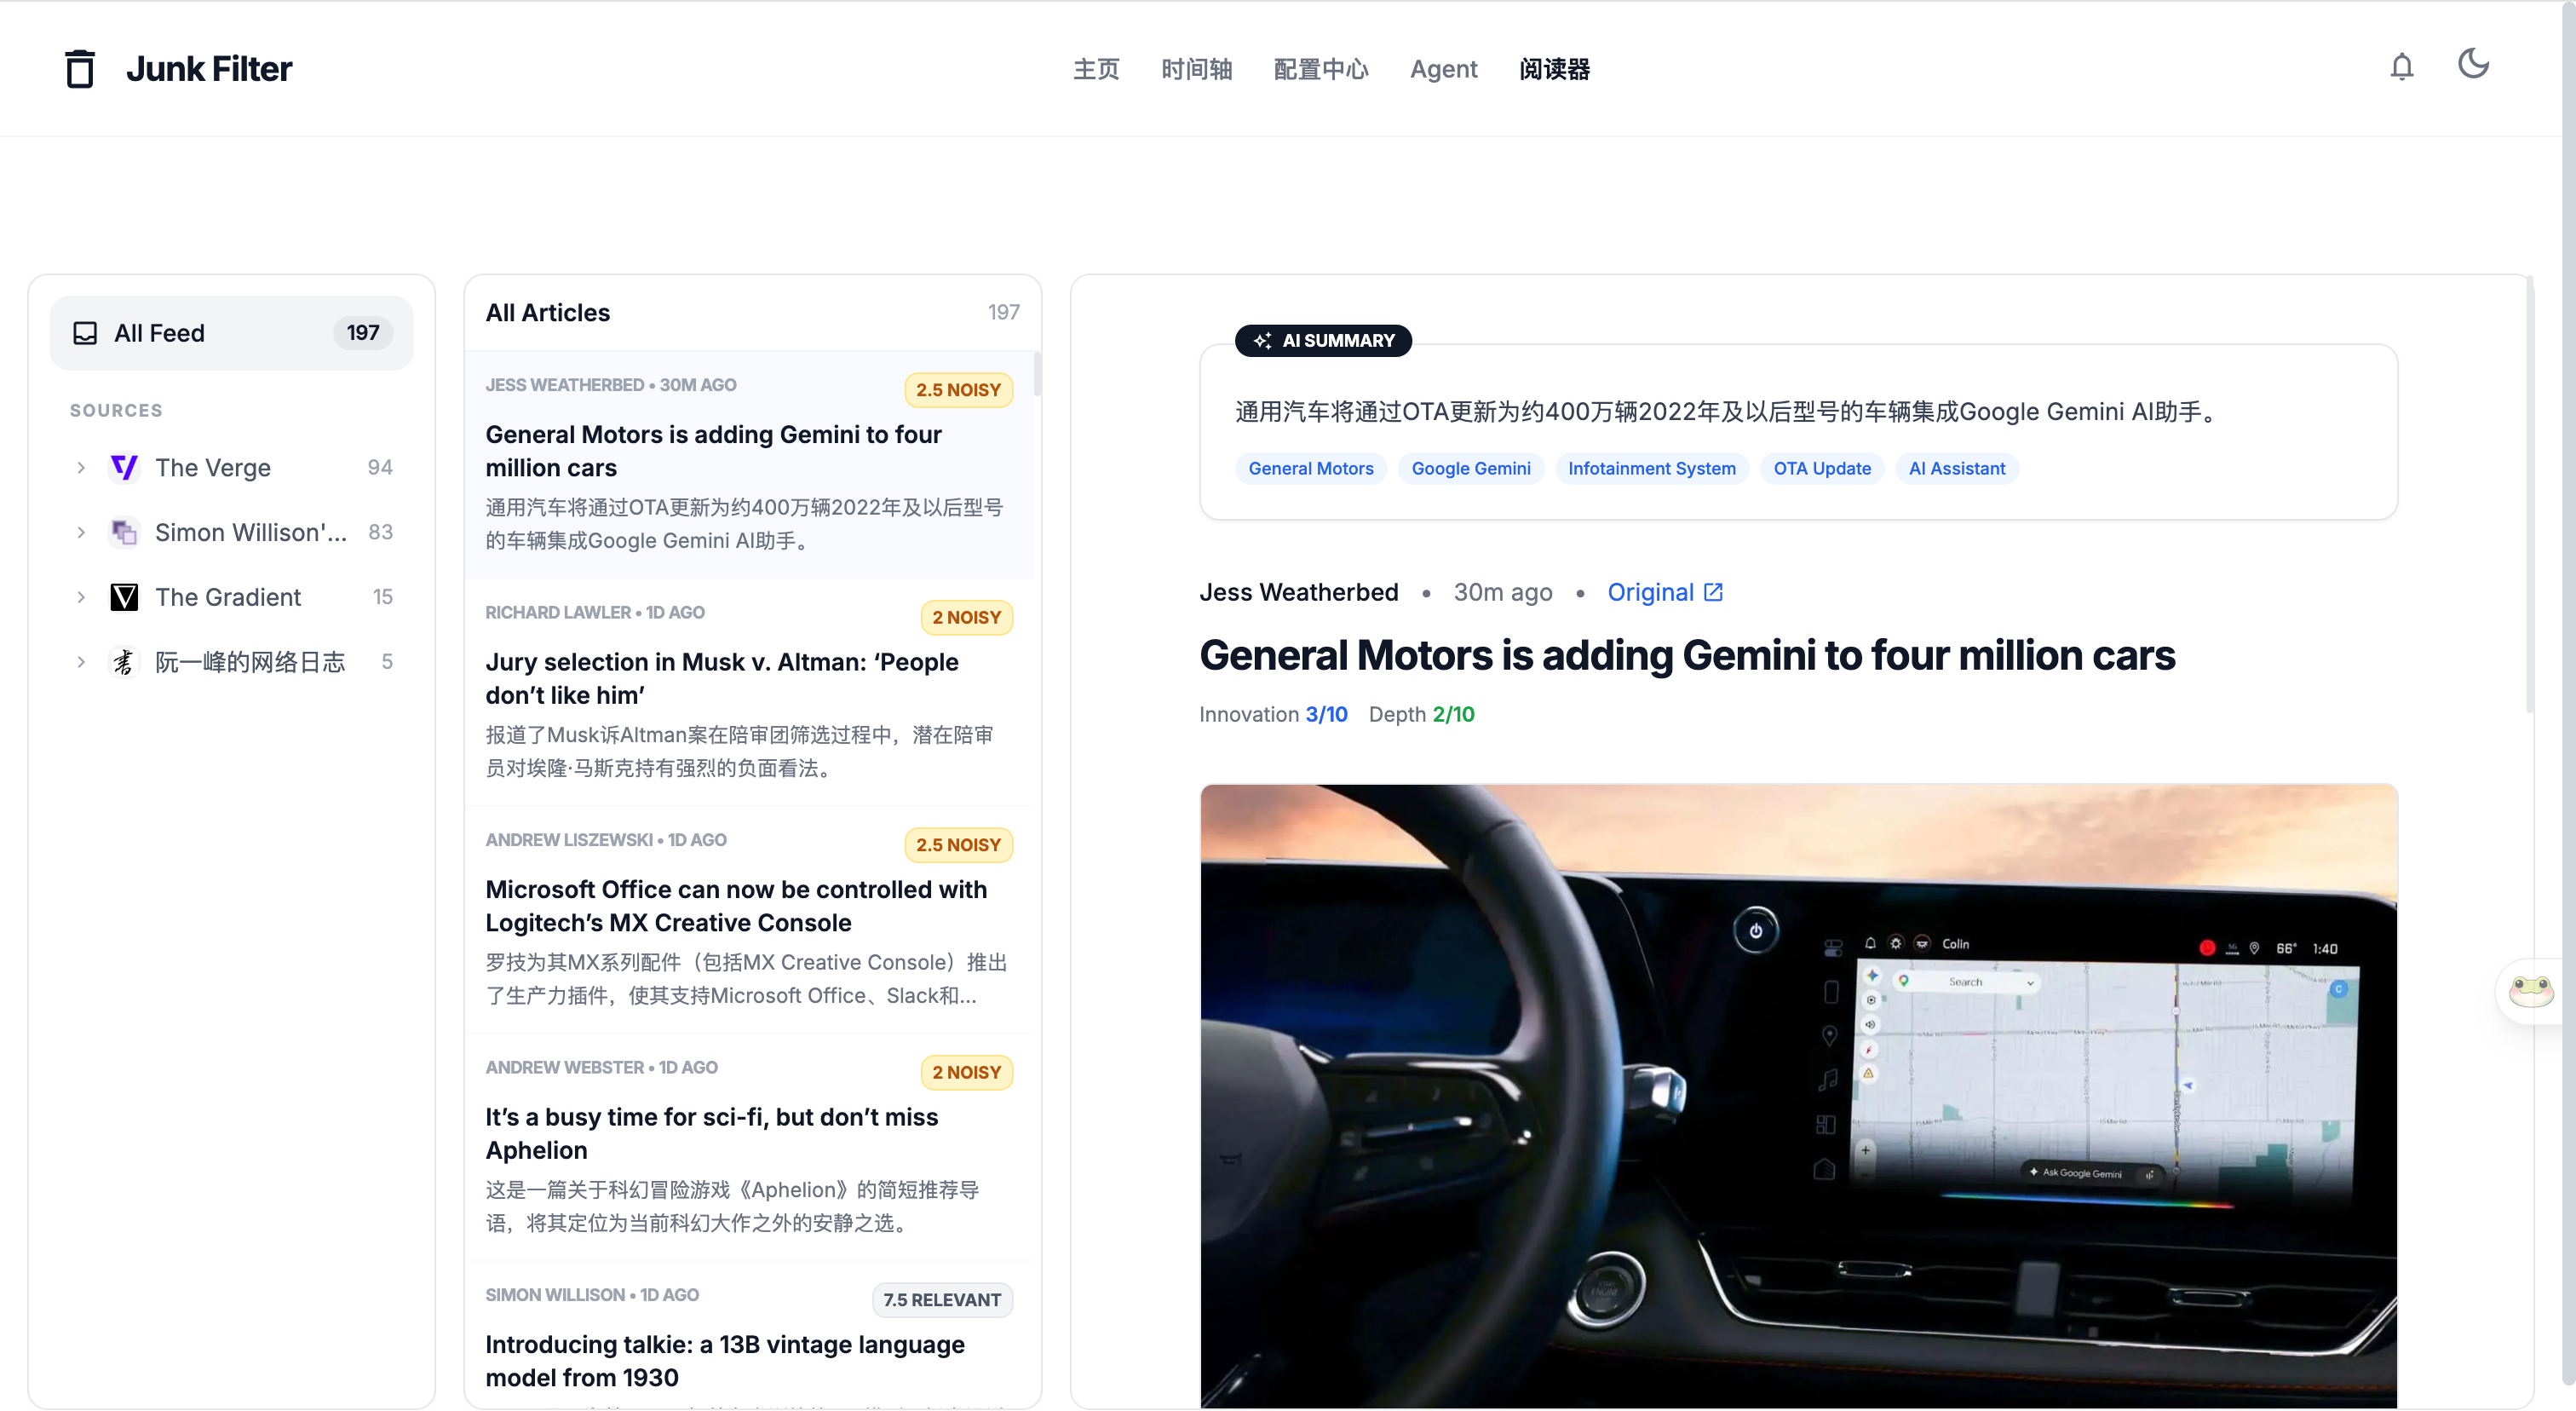
阅读器:在同一页面读摘要与正文
Agent:自然语言查询与工具调用
配置中心:订阅源、模型与推送设置
移动端通知
目前的边界
JunkFilter 现在更接近个人工作台,而不是多租户 SaaS:
- 模型吞吐仍是整条链路的主要瓶颈,当前 Consumer 以稳定处理和故障恢复为优先;
- 对话历史主要保存在进程内,Bot 重启后不会恢复;
- Tauri 只是可选的桌面封装,主要使用方式仍是本地 Web 页面;
- 评估分数用于个人排序,不应被理解为通用内容质量基准。
这几个限制并不影响它作为个人 RSS 阅读系统使用,但决定了后续扩展时应优先补任务观测、多消费者并行和多用户隔离,而不是继续增加 Agent 工具数量。